Der weltweite Wettlauf um die leistungsfähigste künstliche Intelligenz erreicht eine neue Eskalationsstufe: Der aktuelle Claude Opus 5.5 Benchmark von Artificial Analysis wirbelt das Spitzenfeld der generativen Sprachmodelle grundlegend durcheinander. Während OpenAI mit seinem Flaggschiff-Modell GPT-6 Astra erst vor wenigen Wochen neue Maßstäbe gesetzt hatte, schiebt sich Anthropics neuester Modellriese Opus 5.5 mit beeindruckender Rechenleistung und herausragenden Problemlösungsfähigkeiten an die absolute Spitze des renommierten Intelligence Index. Doch was bedeuten diese Laborwerte für die unternehmerische Praxis im Mittelstand, und rechtfertigt der gemessene Performance-Gewinn die teils signifikanten Betriebskosten im produktiven Einsatz?
Für Entscheider, CTOs und Digitalisierungsverantwortliche stellt sich selten die Frage, welches Modell in synthetischen Ranglisten auf dem ersten Platz steht, sondern welches System das beste Verhältnis aus Ergebnisqualität, Latenz und Total Cost of Ownership bietet. Der Claude Opus 5.5 Benchmark liefert hierzu eine Fülle an wertvollen Detaildaten, die weit über oberflächliche Jubelmeldungen hinausgehen. Wir haben die Benchmark-Ergebnisse von Artificial Analysis und die ersten Berichte aus der Fachpresse – unter anderem die Analyse auf Heise online zum Claude Opus 5.5 Benchmark – detailliert seziert und in einen praxisnahen Kontext für Unternehmen übersetzt.
Inhalt
Der Intelligence Index: Was misst der Claude Opus 5.5 Benchmark eigentlich?
Um die Aussagekraft eines Performance-Tests fundiert beurteilen zu können, ist ein Blick auf die Methodik unerlässlich. Der von der unabhängigen Plattform Artificial Analysis betriebene Intelligence Index gilt in der KI-Industrie als einer der anspruchsvollsten und neutralsten Maßstäbe. Im Gegensatz zu herkömmlichen akademischen Benchmarks wie MMLU oder GSM8K, bei denen moderne Spitzenmodelle zunehmend an die Decke stoßen (Sättigungseffekte), fasst der Intelligence Index zehn verschiedene, praxisrelevante Testdomänen zusammen.
Hierzu gehören unter anderem:
- Wissenschaftliches Programmieren (Scientific Coding): Das Verstehen komplexer mathematischer Algorithmen, Datenanalysen und die fehlerfreie Implementierung anspruchsvoller Software-Architekturen.
- Kommandozeilen- & Terminal-Aufgaben (CLI / Agentic Workflows): Die Fähigkeit, in realen Entwicklungsumgebungen Befehle auszuführen, Fehlermeldungen autonom zu interpretieren und mehrstufige Problemstellungen zu lösen.
- Komplexe Wissensfragen (Multi-Hop Reasoning): Die Synthese von Informationen über mehrere Disziplinen hinweg, ohne logische Brüche oder faktische Fehler.
- Instruktionstreue & Format-Compliance: Wie präzise das Modell vorgegebene JSON-, XML- oder Programmierschnittstellen-Schemata einhält, ohne unerwünschte Fülltexte zu erzeugen.
- Mathematische Deduktion und logischer Beweis: Schrittweises, transparentes Schließen bei Aufgabenstellungen ohne vordefinierten Lösungsweg.
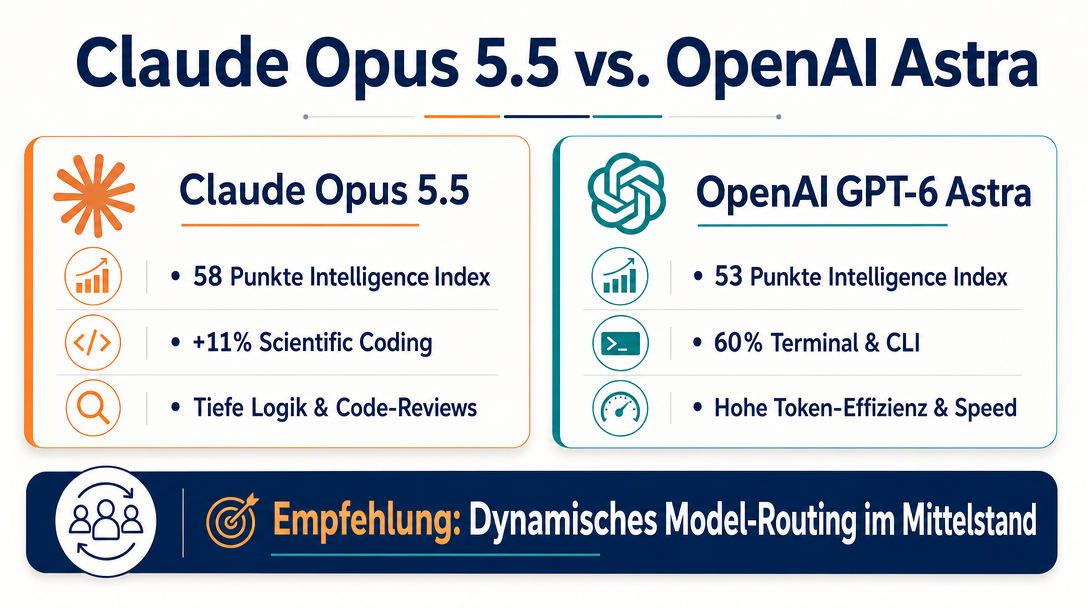
In diesem hochkomplexen Testumfeld erzielte Claude Opus 5.5 einen Gesamtscore von 58 Punkten. Damit überholte es sowohl den bisherigen Spitzenreiter OpenAI GPT-6 Astra (53 Punkte) als auch Anthropics bisheriges Schwergewicht Claude Fable 5.1 (ebenfalls 53 Punkte). Ein Vorsprung von fünf Indexpunkten mag auf den ersten Blick moderat wirken, markiert im Bereich der absoluten Spitzen-LLMs jedoch einen signifikanten Sprung in der kognitiven Tiefe.
Die Detailanalyse: Wo Claude Opus 5.5 glänzt – und wo Astra mithält
Der Blick auf den Gesamtwert im aktuellen Performance-Index allein reicht nicht aus, um strategische Architekturentscheidungen für das eigene Unternehmen zu treffen. Die Detailauswertung offenbart nuancierte Stärken und überraschende Parallelen zwischen den Spitzenkandidaten.
Wissenschaftliches Programmieren und komplexe Code-Synthese
Die größte Differenz zwischen den Modellen zeigt sich beim anspruchsvollen wissenschaftlichen Programmieren sowie bei der Codegenerierung für mathematisch-technische Domänen. Hier deklassiert Claude Opus 5.5 die Konkurrenz regelrecht: Mit einem Vorsprung von satten 11 Prozentpunkten gegenüber OpenAI Astra setzt das Modell einen neuen Branchenstandard. Selbst gegenüber Claude Fable 5.1 konnte Opus 5.5 nochmals um vier Prozentpunkte zulegen.
Für Unternehmen, die KI zur Unterstützung von Software-Ingenieuren, quantitativen Analysten oder Forschungs- und Entwicklungsabteilungen einsetzen, ist diese Leistungssteigerung spürbar. Opus 5.5 neigt signifikant seltener zu subtilen Logikfehlern in Algorithmen, erkennt Randfälle in Datenstrukturen wesentlich zuverlässiger und liefert syntaktisch wie semantisch sauberen Code, der ohne zeitraubendes Debugging produktionsnah eingesetzt werden kann.
Kommandozeilen-Aufgaben und autonome Agenten-Steuerung
Ein ganz anderes Bild zeichnet sich bei praxisnahen Aufgaben an der Kommandozeile ab. Wenn es darum geht, ein Terminal zu bedienen, Bash-Skripte auszuführen, Container-Umgebungen zu diagnostizieren oder Software-Pakete zu kompilieren, liegen Claude Opus 5.5 und OpenAIs GPT-6 Astra mit jeweils rund 60 Prozent Erfolgsquote praktisch gleichauf.
Dieses Patt ist hochgradig aufschlussreich: Beide KI-Schmieden haben ihre Modelle intensiv auf agentische Interaktionen getrimmt. Wer Sprachmodelle primär als Orchestrierungs-Kerne in agentischen Systemen einsetzt – beispielsweise über das offene Model Context Protocol (MCP) –, findet in beiden Lösungen hochentwickelte Werkzeuge. Wie Sie solche Systeme sicher in Ihre Unternehmensprozesse einbetten, beleuchten wir ausführlich in unserem Fachartikel zur Lethal Trifecta bei KI-Agenten und stabiler IT-Sicherheit.
| Benchmark-Kriterium | Claude Opus 5.5 | OpenAI GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Intelligence Index Gesamtscore | 58 Punkte (Platz 1) | 53 Punkte | 53 Punkte |
| Wissenschaftliches Programmieren | Spitzenklasse (+11% vs. Astra) | Solide Basis | Hohes Niveau (+4% unter Opus) |
| Terminal- / CLI-Aufgaben | ca. 60 % Erfolgsquote | ca. 60 % Erfolgsquote | ca. 54 % Erfolgsquote |
| Token-Verbrauch pro Aufgabe | Höhere Ausführlichkeit (mehr Token) | Sehr kompakt (weniger Token) | Mittelmäßig |
| Kosten pro Million Token (Basis) | Günstiger Einzel-Token-Tarif | Höherer Einzel-Token-Tarif | Hoher Tokenpreis |
| Empfohlener Einsatzzweck | Maximale Qualität, F&E, Code-Reviews | Echtzeit-Anwendungen, Kosteneffizienz | Legacy-Pipelines (Ablösung ratsam) |
Der Kosten-Faktencheck: Das Paradoxon der Token-Ökonomie
Einer der spannendsten Aspekte, den der aktuelle Claude Opus 5.5 Benchmark ans Licht bringt, betrifft das Pricing und die sogenannte Token-Ökonomie. In der Marketing-Kommunikation werben viele Provider mit reinen Rohpreisen pro 1.000 oder 1.000.000 Token. Doch wie jeder erfahrene Software-Architekt weiß, spiegeln nominelle Token-Preise nur die halbe Wahrheit wider.
Warum günstigere Token nicht zwingend geringere Rechnungen bedeuten
Die Analyse von Artificial Analysis deckt ein faszinierendes wirtschaftliches Phänomen auf:
- Auf der Preisliste wirkt Claude Opus 5.5 pro einzelnem Token deutlich preiswerter als GPT-6 Astra von OpenAI.
- In der praktischen Aufgabenbearbeitung zeigt sich jedoch, dass Astra für identische Zielergebnisse erheblich weniger Token generiert. Das Modell von OpenAI formuliert kompakter, arbeitet zielgerichteter auf den Punkt und vermeidet weitschweifige Zwischenschritte im Output.
- Claude Opus 5.5 hingegen pflegt eine ausführliche, tiefgründige Denkweise (Chain-of-Thought). Es begründet seine Lösungsschritte detailliert, erzeugt umfangreichere Code-Dokumentationen und benötigt dadurch für eine komplexe Anfrage in der Summe signifikant mehr Output-Token.
Das Ergebnis: Betrachtet man die realen Kosten pro gelöster Aufgabe (Cost per Task), kehrt sich der Vorteil mitunter um. Wer primär standardisierte Klassifizierungen, Kundenservice-Routing oder strukturierte Datenextraktionen durchführt, fährt mit OpenAI Astra trotz höherer Einzel-Tokenpreise am Monatsende oft kostengünstiger. Wer hingegen tiefgehende Analysen, kreative Strategiepapiere oder sicherheitskritische Code-Audits benötigt, profitiert von der enormen kognitiven Tiefe von Claude Opus 5.5 – und nimmt die höhere Tokenmenge für das fehlerfreie Ergebnis gerne in Kauf.
Das ältere Modell Claude Fable 5.1 gerät durch diesen Generationswechsel massiv unter Druck: Es liegt nicht nur in der Leistungsfähigkeit fünf Punkte hinter Opus 5.5, sondern verursacht pro Token auch noch spürbar höhere Kosten. Für bestehende Unternehmensanwendungen bedeutet dies: Eine Migration von Fable 5.1 auf neuere Modellgenerationen sollte zügig auf der IT-Roadmap priorisiert werden. Weiterführende Überlegungen zu technologischen Lebenszyklen finden Sie in unserem Leitfaden zu den großen KI-Trends und Modellentwicklungen.
Praktische Einsatzszenarien: Wann lohnt sich Claude Opus 5.5 im Unternehmen?
Als praxisorientierte Marketing- und Digitalisierungsexperten plädieren wir bei Biteno und Awantego stets für faktenbasierte Entscheidungen. Niemand sollte blind das teuerste Flaggschiff buchen, wenn ein schlankeres Modell denselben Geschäftszweck erfüllt. Basierend auf den Resultaten im Claude Opus 5.5 Benchmark lassen sich vier klare Anwendungsfelder identifizieren, in denen das Anthropic-Modell seinen ROI voll ausspielt:
1. High-End Software-Engineering & Architektur-Reviews
Wenn es um missionskritischen Code geht, wiegen Entwicklerstunden und Produktionsausfälle unverhältnismäßig schwerer als API-Rechnungen. Ein Senior-Entwickler, der zwei Tage lang nach einer Race-Condition oder einem Speicherleck sucht, kostet ein mittelständisches Unternehmen ein Vielfaches der Token-Gebühren einer tiefgründigen Modellprüfung. Dank seiner Dominanz im wissenschaftlichen Programmieren eignet sich Claude Opus 5.5 hervorragend als automatisierter Lead-Architect für Peer-Reviews, Refactorings und kryptografische Validierungen.
2. Regulatorische Dokumentation & Compliance-Audits
Mit der Einführung strenger europäischer Leitplanken – man denke an den EU AI Act, NIS-2 oder branchenspezifische ISO-Zertifizierungen – steigen die bürokratischen Hürden im Mittelstand massiv an. Opus 5.5 zeichnet sich durch eine außergewöhnliche Lesekompetenz bei heterogenen Normtexten aus. Es kann hunderte Seiten Vertrags- und Gesetzeswerk gegeneinander abgleichen, Diskrepanzen markieren und verlässliche Konformitätsberichte erstellen, ohne Fakten zu erfinden.
3. Komplexe Markt- und Wettbewerbsanalysen
Wer strategische Neuausrichtungen plant, benötigt unbestechliche Daten. Statt oberflächlicher Marketingphrasen liefert Opus 5.5 messerscharfe Markt-Synthesen. Wie Unternehmen mit agentischen Suchsystemen eigenständig Marktdaten erschließen, ohne auf hochpreisige Analystenhäuser angewiesen zu sein, zeigen wir in unserem Praxisleitfaden zur Automatisierung von fünf operativen Unternehmensprozessen mit KI.
4. Anspruchsvolle Content-Kreation mit Fachautorität
Die Zeiten, in denen minderwertiger KI-Massen-Content das Web überflutete, sind vorbei. Moderne Suchmaschinen wie Google erkennen Floskeltexte binnen Sekunden und stufen nichtssagende Artikel rigoros ab. Wer heute B2B-Kunden gewinnen will, benötigt tiefschürfende Fachbeiträge mit echter Thought Leadership. Claude Opus 5.5 brilliert darin, abstrakte technische Konzepte verständlich darzustellen und mit praxisnahen Beispielen anzureichern, ohne in typische KI-Floskeln zu verfallen.
Experten-Tipp für die Praxis:
Verlassen Sie sich im Produktivbetrieb niemals auf ein einziges Modell für alle Aufgaben. Etablieren Sie stattdessen ein dynamisches Model-Routing: Leichte Routine-Tasks (E-Mail-Vorfilterung, Stammdaten-Validierung, kurze Chat-Antworten) werden an schnelle, kostengünstige Modelle delegiert. Nur wenn die Komplexität einen definierten Schwellenwert übersteigt, wird die Anfrage an das Spitzenmodell von Claude Opus 5.5 weitergeleitet. Dadurch sichern Sie sich maximale Ausführungsqualität bei minimalen Betriebskosten.
Der Blick auf die Konkurrenz: OpenAI Astra als der agile Allrounder
Wer die Vergleichsdaten der neuen Spitzenmodelle neutral auswertet, darf die Qualitäten von OpenAIs GPT-6 Astra nicht ignorieren. Auch wenn Astra im Intelligence Index um fünf Punkte zurückliegt, bleibt es für viele Unternehmen die pragmatischere Wahl.
Zu den herausragenden Merkmalen von Astra gehören:
- Extrem geringe Latenz (Time to First Token): Für interaktive Benutzeroberflächen, Echtzeit-Sprachassistenten und kundenorientierte Chatbots ist Geschwindigkeit oft wichtiger als die letzte Dezimalstelle an Präzision. Hier reagiert Astra spürbar zügiger als das monolithisch rechnende Opus 5.5.
- Kompakte Antworten für API-Pipelines: Wenn eine Software im Hintergrund tausende Mikro-Transaktionen pro Minute ausführt, führt die knappe Ausdrucksweise von Astra zu signifikanten Einsparungen bei Bandbreite, Speicher und Token-Kontingenten.
- Hervorragende Tool-Calling-Stabilität: Bei rein deterministischen Funktionsaufrufen und Datenbankabfragen agiert Astra extrem verlässlich und schlägt sich im CLI-Benchmark mit 60 Prozent auf Augenhöhe mit Opus.
Die Branchenanalysten von Artificial Analysis fassen dieses Dilemma treffend zusammen: Wer maximale kognitive Leistung benötigt und wissenschaftliche Spitzenqualität einfordert, führt an Claude Opus 5.5 kein Weg vorbei. Wer hingegen Budgets strikt kontrollieren muss, hohe Durchsätze bewältigt und dennoch ein Modell auf Weltklasse-Niveau verlangt, findet in Astra die wirtschaftlich ausgewogenere Lösung.
Integration und Infrastruktur: Worauf Unternehmen jetzt achten müssen
Ein technologischer Spitzenreiter nützt wenig, wenn er als isolierte Insellösung im Elfenbeinturm betrieben wird. Um Modelle wie Claude Opus 5.5 oder OpenAI Astra wertschöpfend in bestehende Unternehmens-IT einzubinden, müssen solide architektonische Grundlagen geschaffen werden. Dabei sind drei Kernbereiche entscheidend:
1. Datenschutz und Compliance (DSGVO)
Spitzenmodelle erfordern klare vertragliche Regelungen. Gemäß den aktuellen Bestimmungen des Branchenverbands Bitkom und der europäischen Datenschutz-Grundverordnung müssen Unternehmen sicherstellen, dass übermittelte Unternehmensdaten weder für das Nachtraining der Basissysteme verwendet noch ungesichert auf Drittservern gespeichert werden. Bei der Anbindung von Claude Opus 5.5 über Enterprise-APIs oder Hyperscaler-Plattformen (wie AWS Bedrock oder Google Cloud Vertex AI) müssen entsprechende Auftragsverarbeitungsverträge (AVV) hinterlegt sein.
2. Protokoll-Standardisierung mit MCP
Statt proprietäre Schnittstellen für jeden Provider individuell zu programmieren, setzt sich in der modernen IT-Landschaft das Model Context Protocol (MCP) als herstellerübergreifender Standard durch. Ein zentraler MCP-Gateway ermöglicht es, KI-Agenten flexibel mit firmeninternen Datenbanken, ERP-Systemen oder Dateispeichern zu verbinden – und das zugrundeliegende Sprachmodell bei neuen Benchmark-Sprüngen im Handumdrehen auszutauschen. Wenn Sie eine solche zukunftssichere Infrastruktur aufbauen möchten, steht Ihnen das Team der Biteno IT-Systemhaus GmbH als erfahrener Partner für professionelle IT-Betreuung und Agenten-Architekturen zur Seite.
3. Monitoring und Budget-Caps
Aufgrund des höheren Token-Volumens von Opus 5.5 sollten zwingend harte Ausgaben-Limits (Hard Quotas) auf API-Ebene eingerichtet werden. Unkontrollierte Endlosschleifen in unausgereiften Agenten-Skripten können bei Flaggschiff-Modellen innerhalb weniger Stunden erhebliche Kosten verursachen. Ein professionelles Logging aller Prompt- und Completion-Token gehört daher zur Grundausstattung jeder unternehmensweiten KI-Initiative. Weiterführende strategische Leitplanken für den Rollout finden Sie in unserer Schritt-für-Schritt-Anleitung zur Erstellung einer KI-Roadmap.
Entscheidungsmatrix: Welches Modell für welches Projekt?
Um Ihnen die Auswahl zu erleichtern, haben wir die Resultate aus dem Claude Opus 5.5 Benchmark in eine handlungsorientierte Entscheidungsmatrix überführt. Prüfen Sie anhand der folgenden Kriterien, welches Sprachmodell zu Ihrem aktuellen Projekt passt:
| Projektanforderung | Empfohlenes Modell | Strategische Begründung |
|---|---|---|
| Wissenschaftliche Berechnungen & Data Science | Claude Opus 5.5 | 11% Vorsprung im wissenschaftlichen Coden sichert überlegene Algorithmen-Qualität. |
| Kritische Code-Reviews & Sicherheits-Audits | Claude Opus 5.5 | Tiefes Reasoning minimiert False Positives und erkennt subtile Logikbrüche. |
| Interaktive Kunden-Chatbots (Live-Support) | OpenAI GPT-6 Astra | Schnellere Reaktionszeiten und kompaktere Formulierungen schonen Budget und Nerven der Nutzer. |
| Großvolumige Dokumenten-Klassifizierung | OpenAI GPT-6 Astra | Geringerer Tokenverbrauch führt bei Massendaten zu spürbar niedrigeren Gesamtkosten. |
| Autonome CLI- & DevOps-Agenten | Beide gleichauf (Opus 5.5 oder Astra) | Beide Modelle erzielen rund 60% im Terminal-Test; Wahl abhängig von bestehendem Cloud-Ökosystem. |
| Altsysteme mit Claude Fable 5.1 | Sofortige Migration empfohlen | Fable 5.1 ist sowohl leistungsschwächer als auch im Tokenpreis unwirtschaftlich geworden. |
Zukunftsausblick: Die nächste Innovationswelle rollt bereits
Die Dynamik, die dieser Generationswechsel im KI-Markt dokumentiert, verdeutlicht eine fundamentale Wahrheit: Die Halbwertszeit von KI-Spitzenplätzen wird immer kürzer. Noch vor einem Jahr schien die Vormachtstellung einzelner Modelle über Monate hinweg zementiert. Heute wechselt die Krone der Spitzenreiter im Quartalstakt.
Für mittelständische Betriebe resultiert daraus eine zentrale Lektion: Investieren Sie Ihr Budget niemals primär in die Bindung an ein einzelnes Modell, sondern investieren Sie in die Flexibilität Ihrer internen Daten- und Schnittstellen-Architektur. Wer seine Wissensdatenbanken sauber strukturiert, offene API-Standards nutzt und klare Governance-Regeln etabliert, kann jeden neuen Benchmark-Gewinner binnen weniger Tage aktivieren und geschäftlichen Mehrwert generieren – egal, ob dieser von Anthropic, OpenAI oder aus dem Open-Source-Lager stammt.
Zusätzlich gewinnt das Zusammenspiel verschiedener Modalitäten rapide an Bedeutung. Nicht nur reiner Text, sondern die synchrone Verarbeitung von Audio-, Video- und Sensordaten wird die nächste Generation von Unternehmensanwendungen definieren. Einen fundierten Einstieg in diese Zukunftstechnologie bieten wir in unserem Übersichtsartikel zum Thema Multimodale KI und ihre Einsatzchancen.
Fazit: Claude Opus 5.5 setzt die Benchmark-Krone auf – mit klarem Preisschild
Der neue Claude Opus 5.5 Benchmark von Artificial Analysis bestätigt eindrucksvoll die Innovationskraft von Anthropic. Mit 58 Punkten im Intelligence Index beansprucht Claude Opus 5.5 völlig zu Recht den Titel des derzeit leistungsfähigsten Sprachmodells der Welt. Besonders in anspruchsvollen Domänen wie dem wissenschaftlichen Programmieren und dem mehrstufigen analytischen Denken verweist das Modell die Konkurrenz auf die Plätze.
Gleichzeitig mahnt die detaillierte Kostenanalyse zur Besonnenheit: Spitzenleistung hat ihren Preis. Da Opus 5.5 für dieselben Aufgaben deutlich mehr Token beansprucht als die kompaktere Konkurrenz von OpenAI, bleibt Astra für hochvolumige Standardprozesse die kaufmännisch attraktivere Wahl. Für die unternehmerische Praxis lautet das Fazit daher: Setzen Sie Claude Opus 5.5 dort ein, wo exzellente Qualität den Unterschied zwischen Erfolg und Fehlschlag ausmacht – und steuern Sie Ihre Workflows mit einem intelligenten, mehrstufigen Modellmix.